
基于摩根指纹与机器学习的Tox21毒性预测及支架划分性能评估
本研究旨在评估传统分子指纹与树集成模型在化学毒性筛选中的预测表现。研究基于分子骨架拆分构建严苛验证基准,对比了随机森林与XGBoost在12项毒性终点上的排序性能与二分类决策表现。
研究问题
高通量化学毒性预测面临数据严重类不平衡、标签缺失普遍以及结构相似导致随机拆分信息泄露的问题。传统评估常因随机划分而夸大模型对外推化学空间的泛化能力,无法如实反映筛选场景中对新颖结构化合物的识别水平。本研究旨在检验在严格分子骨架拆分与不平衡处理策略下,传统树模型的毒性预测能力上限,并评估排序能力与二分类决策性能之间是否存在偏离。
研究路径
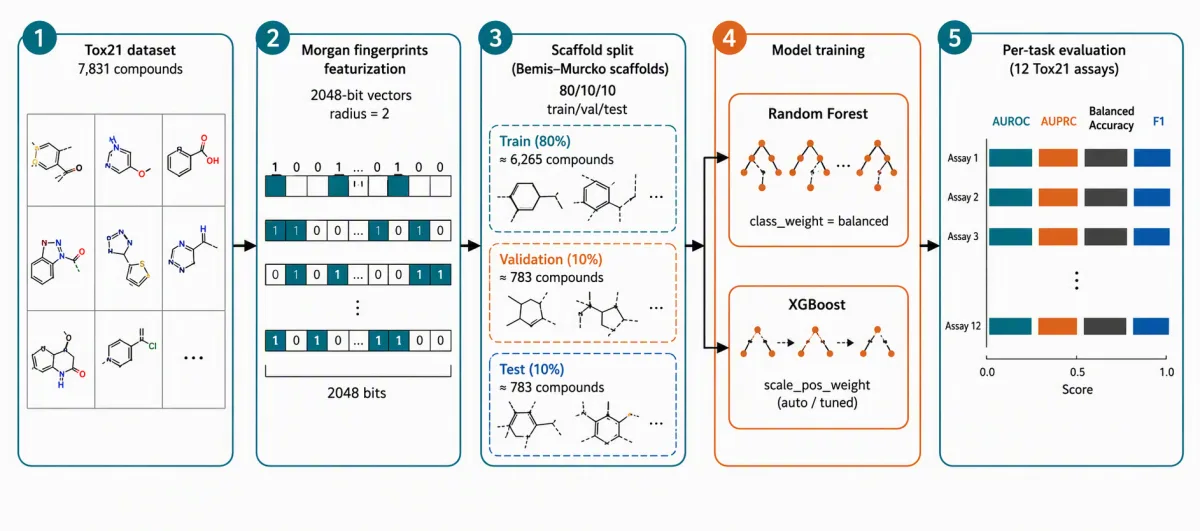
作者采用基于化学结构的单任务独立建模策略,结合骨架拆分与验证集阈值优化展开研究。研究基于Tox21基准数据集中的7831个小分子化合物,覆盖7项核受体与5项应激响应毒性终点,使用RDKit将其表征为2048位Morgan分子指纹(半径为2)。数据划分采用Bemis–Murcko分子骨架拆分(80%训练集、10%验证集、10%测试集),将同骨架化合物归入同一子集,并在各任务内部剔除未测量标签。模型方面训练了结合类别权重平衡的随机森林与缩放正样本梯度的XGBoost;在验证集上通过网格搜索确定使F1分数最大化的分类阈值,随后在测试集上独立评估AUROC、AUPRC、平衡准确率与F1分数。
核心发现
测试结果表明,XGBoost在跨任务总体排序性能上略占优势,而随机森林在固定决策点的不平衡分类表现上更为稳定。
在整体排序性能上XGBoost略优,但在二分类识别精度上随机森林表现更好。 XGBoost取得了略高的平均AUROC(0.719对比0.708)与平均AUPRC(0.283对比0.278),而随机森林获得了较高的平均平衡准确率(0.618对比0.595)和平均F1分数(0.277对比0.235)。
在极度不平衡任务中,高AUROC指标与实际二分类识别能力存在严重脱节。 在测试集仅有12与14个阳性的NR-AR与NR-AR-LBD任务中,尽管XGBoost在NR-AR-LBD上达到0.845的AUROC,但受骨架外推与极稀缺阳性样本影响,两模型在该类任务上的测试集F1分数均崩溃至0。
验证集阈值优化展现出两类模型在不平衡权重调节下的机制差异。 随机森林的最佳阈值紧密围绕0.5(0.48—0.75),而XGBoost阈值高度分散(0.11—0.83),反映梯度缩放拉高了正类预测概率。
本研究在骨架拆分基准下量化了分子指纹与树模型的预测上限,揭示了排序能力与正类识别精度之间的权衡关系,为毒性筛选模型的评估提供了客观基准。
适用边界
本研究结论的解释与外推受限于二维特征表征能力、单任务架构及数据分布边界。二维Morgan指纹未编码三维构象与电子效应,导致模型在立体结构敏感的雌激素受体终点(如NR-ER-LBD)上表现较弱(AUROC仅0.559—0.592);单任务独立建模未能利用多靶点间的相关性信号;此外,固定超参数与单次拆分在极端不平衡任务上存在明显的划分方差。
这些限制表明,当前模型适用于早期化合物库的高通量粗筛与优先级排序,尚不能独立用于三维立体异构体毒性的精细判定或直接替代高风险监管实验。