
人类蛋白质相互作用组的拓扑链接预测及机器学习模型综合比较
本研究旨在评估仅依靠网络拓扑特征预测人类蛋白质相互作用的可行性与边界,通过构建基于 STRING 数据库的万级网络并提取 6 种拓扑指标,对比了多种机器学习模型的预测效能,发现线性逻辑回归与正则化 XGBoost 均能实现优异的预测性能(AUROC > 0.97),且资源分配指数在预测中占据主导地位。
研究问题
蛋白质相互作用(PPI)是细胞生命活动的核心基础,但通过湿实验全面测定庞大的人类蛋白质相互作用组成本高昂且周期漫长。利用图计算与机器学习进行拓扑链接预测是一种高效率的计算替代方案,然而现有研究对于"仅凭纯网络拓扑结构能够在多大程度上准确推断未知的相互作用"这一问题尚缺乏系统验证。
具体而言,拓扑特征如公共邻居、资源分配和最短路径等,在衡量蛋白质对的互动倾向时各自发挥什么作用,以及复杂的非线性模型是否显著优于简单线性模型,仍存在认识模糊。本研究准备检验不同拓扑特征在预测相互作用时的相对重要性,并论证机器学习模型在不同节点度数分布下的泛化能力与预测边界。
本研究试图回答的核心问题是:基于纯拓扑特征的模型能否可靠预测人类蛋白质相互作用,以及决定预测精度的核心拓扑因素和模型结构是什么。
研究路径
为了系统回答上述问题,作者采用了"高置信网络构建—无数据泄漏特征提取—多模型对比与度分层验证"的整体研究策略。
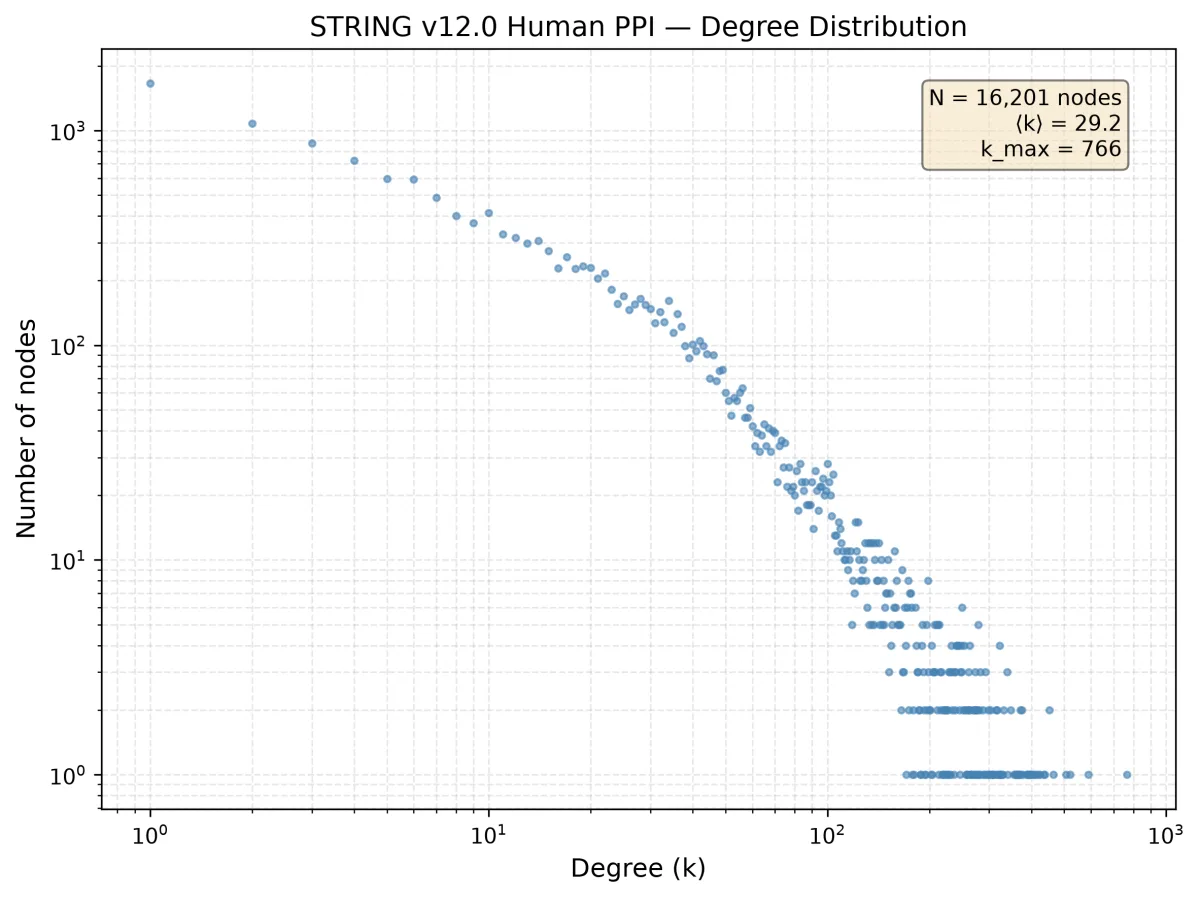
研究基于 STRING v12.0 数据库筛选人类蛋白质数据,严格限制联合置信度得分不低于 0.7,构建了一个包含 16,201 个蛋白质节点和 236,930 条高置信度相互作用边的无向图。为防止评估过程中的数据泄漏,研究将边按比例划分为训练集(81.15%)、验证集(9.00%)和独立测试集(10.00%),并通过拒绝采样为验证集与测试集分别抽取等数量的非边作为负样本,同时在删边训练图中恢复了 351 个潜在孤立节点的最小连接。
在方法选择上,研究仅利用训练图拓扑结构计算了公共邻居、Jaccard系数、Adamic-Adar指数、优先连接、资源分配指数及最短路径长度等 6 项独立拓扑特征。随后,研究训练并对比了逻辑回归、随机森林以及经过正则化调优的 XGBoost 三类典型模型,使用 2000 次 Bootstrap 抽样估计置信区间,并进一步通过置换特征重要性与度分层分析,检验模型在不同蛋白质连接度下的决策机制与稳定性。
核心发现
评估结果显示,仅依靠网络拓扑特征即可实现高精度的人类蛋白质相互作用预测,且决策边界在拓扑特征空间中近似线性。
- 线性模型与正则化 XGBoost 表现高度接近,表明拓扑预测空间具有强线性可分性。在 held-out 测试集上,正则化 XGBoost 取得 0.9750 的 AUROC(95% CI: 0.9735–0.9765),逻辑回归取得 0.9723 的 AUROC(95% CI: 0.9709–0.9738),二者置信区间高度重叠;而轴向切割的随机森林表现较低(AUROC 0.7344),提示该特征空间更适合线性或连续光滑的决策面。
- 资源分配指数是线性预测的主导特征,而最短路径长度在树模型中占据极高权重。置换特征重要性与回归系数分析显示,资源分配指数在逻辑回归中的系数达 +13.43,在 XGBoost 置换重要性中贡献最高(0.2490);而随机森林与 XGBoost 的树拆分过程则高度依赖最短路径长度指标。
- 预测性能随着蛋白质节点度数的降低出现轻微衰减,但仍保持较高可靠性。按节点度数乘积中位数(527.0)将测试集分为高、低度数两组,逻辑回归与 XGBoost 在高度数对上的 AUROC 超过 0.984,而在低度数(稀疏连接)对上 AUROC 保持在 0.911–0.916,表明模型对低度数蛋白质依然具备较强的预测能力。
本研究的贡献在于系统评估了纯拓扑特征在人类 PPI 预测中的上限,澄清了复杂树模型与线性模型的性能差异,并揭示了资源分配指数在拓扑链接预测中的关键作用。
适用边界
本研究结论的解释与应用受限于已知拓扑结构的完备度以及无生物学序列信息的单一特征源。
首先,研究数据集依赖于 STRING 数据库中已知的高置信度 PPI 网络,拓扑计算建立在已观察到的网络结构之上,对于完全缺乏已知相互作用的全新蛋白质(孤立节点),模型无法直接提取有效拓扑特征。其次,低度数节点的预测性能相对较低(AUROC 0.911 vs 0.984),提示在网络边缘或稀疏区域,纯拓扑信息的有效性受到一定限制。此外,模型未整合蛋白质序列、三维结构或表达谱数据,其统计预测结果尚不能替代生物化学或物理相互作用的直接机制检验。
本研究当前能够证明纯拓扑机器学习模型可作为大规模 PPI 筛选的有效优先排序工具,但尚不能支持直接用拓扑预测替代湿实验验证的更强结论。