
基于传统分子描述符与集成机器学习方法预测QM9分子的HOMO–LUMO能隙
针对量子化学前沿轨道能隙(HOMO–LUMO能隙)的高精度计算(如密度泛函理论DFT)难以直接扩展至超大规模分子库高通量筛选的问题,本研究基于包含约13.4万个有机小分子的QM9数据集,建立了一套仅依赖纯2D分子结构与CPU算力的传统机器学习预测方案。在严格按Murcko骨架分割的20,000个分子子集上,XGBoost模型实现了0.269 eV的测试集平均绝对误差(MAE)与0.914的拟合优度($R^2$),证明了传统描述符与集成学习在无需3D结构与GPU算力的前提下,即可接近杂化DFT参考误差的水平。
研究问题
前沿分子轨道能隙(HOMO–LUMO能隙)决定了分子的光电吸收、反应活性与电荷传输特性,是材料与药物分子筛选的关键物理指标。虽然基于Kohn–Sham密度泛函理论(DFT,如B3LYP/6-31G(2df,p)级别)可以精准计算该能隙,但其计算复杂度随分子规模急剧上升。近年来出现的等变图神经网络(Equivariant GNNs)虽能达到数十毫电子伏(meV)的极高精度,但极度依赖分子3D构象、GPU算力与庞大训练集。因此,本研究的核心问题是:仅使用纯2D分子结构特征(无需3D坐标与GPU)与经典树状集成机器学习算法,能否在严格的骨架外推(Scaffold Split)测试集上,以较低的算力成本实现对QM9分子HOMO–LUMO能隙的高精度预测?特征重要性分析能否恢复出符合化学直觉的物理规律?
研究路径
为回答上述问题,研究团队从QM9数据集中随机抽取20,000个分子(固定随机种子random_state=42),并按Bemis–Murcko分子骨架进行了80/10/10的严控泄漏划分(训练集16,000 / 验证集2,000 / 测试集2,000),确保训练集与测试集之间无任何相同骨架(Scaffold Overlap = 0)。
在分子表征方面,研究将20个RDKit全局2D分子描述符(如分子量、环数量、拓扑分子极性表面积TPSA、计算LogP、sp^3杂化碳原子比例FractionCSP3、最大/最小局部电荷等)与1,024位的Morgan摩根指纹(半径2,ECFP4)进行拼接,构建了1,044维的特征向量(摒弃了重原子数量特征以防尺寸泄漏)。
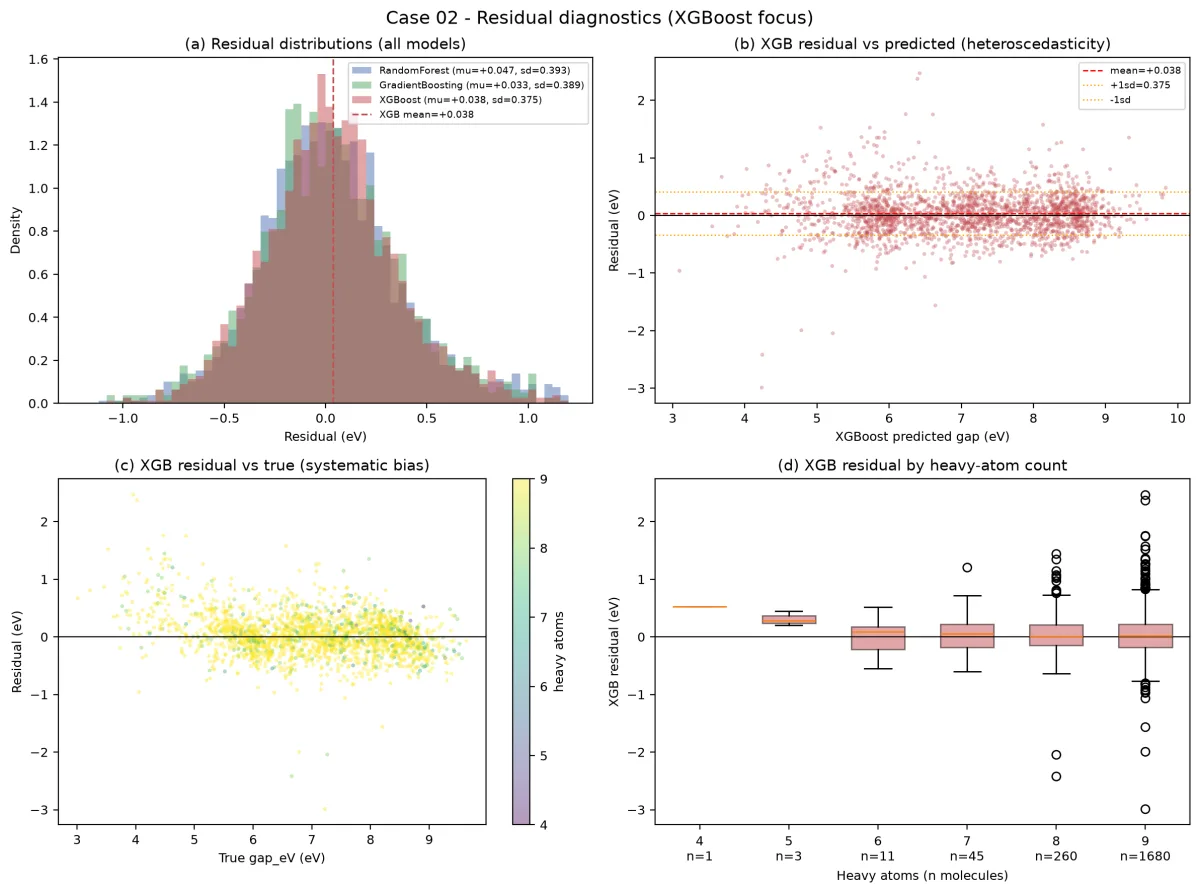
在建模与评估阶段,研究团队在训练集上通过5折交叉验证(5-fold CV)网格搜索,对随机森林(Random Forest)、梯度提升树(Gradient Boosting)和XGBoost三种集成回归模型进行了超参数调优。模型训练完成后,在独立的验证集与测试集上评估了MAE、RMSE及 R^2,并针对不同重原子数分布进行了分组误差分析、残差正态性检验以及基于XGBoost Gain重要性的特征可解释性分析。
核心发现
研究结果显示,纯2D表征结合XGBoost算法展现出优异的能隙预测能力,且模型特征调取逻辑与量子化学规律高度一致。
- XGBoost在三类集成模型中表现最佳,且无跨划分分布偏移。在包含2,000个未见骨架分子的测试集上,XGBoost实现了 0.269 eV 的最高预测精度(MAE),RMSE为0.377 eV,R^2 达 0.914,优于随机森林(MAE 0.285 eV,R^2 = 0.905)和梯度提升树(MAE 0.286 eV,R^2 = 0.907)。验证集到测试集的MAE变化仅为 +0.004 eV,证实骨架划分下模型泛化表现极佳,无分布偏移。
- 不同分子尺寸下的预测性能保持稳定,主要误差来源于特定荷电结构。在包含最丰富分子类型的8与9重原子数区间(占测试集97%),XGBoost的预测MAE保持在0.263—0.269 eV。残差分析表明,86.1%的预测误差控制在 \pm 0.5 eV以内;最大的预测偏差集中于两性离子与偶极带电分子(如甜菜碱、季胺盐),由于2D拓扑指纹无法有效编码其离域正负电荷分布,导致能隙被显著低估。
- 模型自动提炼出“饱和度决定能隙”的经典量子化学规律。特征重要性分析显示,
FractionCSP3(sp^3杂化碳原子比例)是重要性最高的非指纹描述符(Gain达到38.2)。数据验证表明,测试集中高FractionCSP3分子的真实能隙比低饱和度分子平均高出 +1.587 eV,而XGBoost预测出的增益效应为 +1.577 eV,近乎无偏地重现了“饱和度越高、\pi 共轭越少、HOMO–LUMO能隙越大”的物理规律。
总结而言,本论文证明了无需3D构象与GPU硬件,仅凭传统2D分子描述符与CPU运行的XGBoost算法,即可在秒级时间内实现接近杂化DFT参考误差级别的HOMO–LUMO能隙预测。
适用边界
本研究结论的推导与应用受限于特定条件。首先,本研究为控制CPU计算时间,采用了20,000个分子的采样集进行训练,学习曲线表明模型尚未完全达到饱和,使用全量13.4万分子训练可能进一步降低误差。其次,表征方法完全基于2D结构,缺乏3D立体构象与三维电荷分布信息,因此在面对强偶极两性离子或立体异构体时预测误差较大。此外,由于QM9集中4与5个重原子的极小分子数量极其稀少(测试集仅1—3个),小尺寸分子的误差统计具有统计脆弱性。
基于现有证据,该研究能够支持在常规小分子有机光电材料与合成化学筛选中,作为CPU级、秒级响应的高通量能隙初筛 surrogate 模型;但尚不足以替代3D图神经网络对复杂空间构象/带电分子的量子化学级微调,亦不能直接用于预测未包含在2D描述符中的三维空间立体异构体性质。