
基于成分的无机晶体带隙预测及其留元敏感性分析与模型基准对比
针对高通量材料筛选中密度泛函理论(DFT)带隙计算成本高昂且依赖已知晶体结构的问题,本研究基于JARVIS-DFT数据库中的55,710种无机化合物,仅利用化学成分信息构建了74维特征向量,对比了随机森林、XGBoost与核脊回归(KRR)的预测性能,并系统开展了留一元素(Leave-One-Element)外推敏感性分析。研究表明,随机森林在随机划分下实现了0.305 eV的最佳平均绝对误差(MAE),但留一元素实验(特别是氧元素剔除)揭示了模型在面对化学外推与标签分布偏移时的严重性能衰退。
研究问题
电子带隙是决定无机固体材料电学、光学与光伏性能的核心指标。通过半局域DFT(如OPTB88vdW泛函)计算带隙虽能实现大批量筛选,但依然存在计算资源消耗大、必须已知晶体结构、且半局域泛函系统性低估带隙(导致大量半导体被误判为金属)的问题。仅基于化学成分的机器学习模型无需已知晶体结构即可预测带隙,极具应用价值。然而,当前材料信息化研究普遍依赖随机训练/测试集划分,这容易掩盖模型在面对未见元素(元素外推)时的真实表现;同时,数据集中金属(带隙 <0.05 eV)占比过高引发的重度标签失衡,也使得整体评价指标难以反映非金属半导体/绝缘体的真实预测水平。因此,本研究的核心问题是:在无晶体结构信息的纯成分表征下,机器学习预测DFT带隙的精度上限何在?模型在面对未见化学元素时的外推泛化边界在哪里?
研究路径
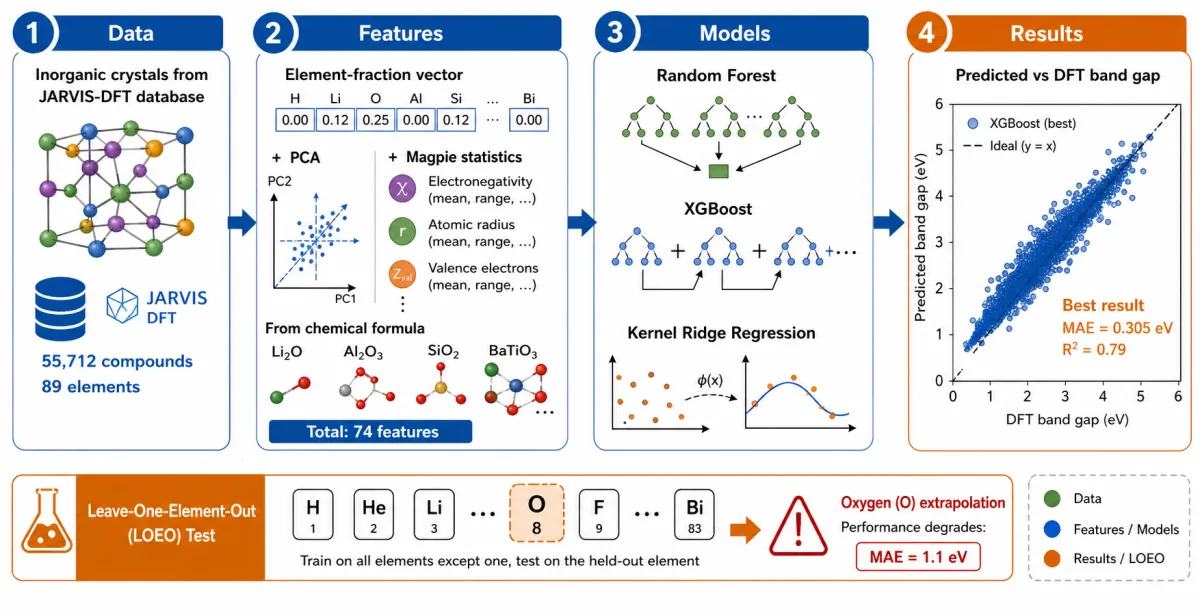
为回答上述问题,研究团队从JARVIS-DFT数据库(dft_3d集合)中获取了55,710种无机化合物的OPTB88vdW带隙数据与化学式。表征构建完全基于化学成分:首先将化学式解析为89维元素分数向量,经主成分分析(PCA)降维保留95%累计方差(65维);再结合Magpie描述符提取化合物中元素电负性、原子半径与价电子数的统计量(均值、最大值、最小值共9维),拼接组成74维特征向量。
研究按80/10/10构建了严控数据泄漏的随机训练/验证/测试集(44,568训练/5,571验证/5,571测试),并在固定超参数下训练随机森林(RF,400棵树)、XGBoost(500棵树,含早停机制)与核脊回归(KRR,RBF核,8,000样本子集训练)。评估指标包括整体MAE、RMSE与 R^2,并按金属性(带隙 <0.05 eV与 \geq 0.05 eV)进行了分分层评估。此外,研究选取氧(O)、钛(Ti)、铜(Cu)三种代表性元素开展留一元素外推实验(测试集仅含该元素,训练集完全剔除该元素并重新拟合特征变换器与模型),并利用置换重要性(Permutation Importance)解析驱动预测的核心物理特征。
核心发现
研究结果显示,纯成分模型在同一化学空间内具备良好的内插预测能力,但在面对关键元素的化学外推时表现出显著的脆弱性。
- 随机森林在随机测试集上表现最佳,准确率接近结构敏感模型。在5,571个随机测试样本上,随机森林达到了最低的整体MAE(0.305 eV,R^2 = 0.788),优于XGBoost(MAE 0.342 eV,R^2 = 0.792)与KRR(MAE 0.528 eV,R^2 = 0.597)。置换重要性分析证实,化合物最大电负性(X_{\text{max}})、价电子统计量与平均原子半径是驱动预测的最关键物理特征。
- 性能严重受金属相主导,非金属相预测难度更大。受OPTB88vdW泛函低估带隙影响,数据集中68.6%为金属(零带隙)。所有模型在金属子集上的误差(RF金属MAE为0.165 eV)均远低于非金属子集(RF非金属MAE为0.621 eV,R^2 = 0.738),表明总体低误差很大程度上归因于大量零带隙金属的精准识别。
- 留一元素实验揭示了元素外推与分布偏移双重失误机制。剔除氧元素(O)使RF的MAE暴增近4倍(达到1.196 eV,\Delta\text{MAE} = +0.891 eV),这是由于氧的剔除不仅移除了关键元素,还导致训练集(78%金属)与测试集(42%金属)发生剧烈的目标分布偏移;剔除铜元素(Cu)虽然MAE增加有限(0.453 eV),但由于测试集均为窄带隙铜化合物,预测值偏离导致 R^2 骤降至 negative(-0.741),证实模型在未见元素外推时可能完全丧失解释力。
总结而言,本论文确立了基于成分预测无机晶体带隙的透明基准,量化了化学内插与外推之间的性能鸿沟,证明了不依赖晶体结构的纯成分模型在快速初筛中的有效性,同时强调了建立化学结构化验证协议的必要性。
适用边界
本研究结论的推导与应用受限于特定条件。首先,训练与评估使用的标签来自OPTB88vdW半局域DFT泛函,其本身存在系统性带隙低估,模型预测结果继承了这一物理近似偏差,不能等同于实验带隙或HSE06杂化泛函带隙。其次,表征方法完全忽略了晶体结构信息,因而无法区分同分异构体/多晶叠合体(数据集中有10,783个记录共享化学式但带隙不同),这构成了纯成分模型的天然噪声上限。此外,KRR模型因内存限制采用了8,000样本子集训练且未调优超参数,其表现不能代表核方法的理论极限。
基于现有证据,该研究能够支持在已知化学元素空间内对未知配比无机化合物进行高通量带隙快速初筛;但尚不足以支持对包含未见元素(特别是阴离子如氧、氟)的新型化合物进行可靠的带隙外推预测,亦不能用于区分同成分不同晶相材料的带隙差异。